

"AI 덕분에 빨라졌어요"와 "AI 때문에 더 피곤해요"가 같은 회의실에서 동시에 들린다.
둘 다 진심이고, 측정해 보면 둘 다 사실이다. 개인의 작업은 빨라지는데 그 산출물을 조직이 검증하는 비용이 새로 생기기 때문이다. 초안은 넘치고 확인할 사람은 그대로다. 게다가 상당수 직원은 회사 몰래 AI를 쓴다. 효율은 개인 주머니에 쌓이고 피로는 조직 장부에 쌓인다.
가인지경영원은 회의실에서 의심 없이 오가는 AI에 관한 문장 7개를 실험대에 올렸다. 근거는 전부 실측 연구다. METR, MIT 미디어랩, 하버드·INSEAD, 스탠퍼드, 맥킨지, MIT 슬론. 검증 결과 일곱 개 모두 반대였다.
먼저, 두 보고가 왜 동시에 사실인가
네 개의 숫자를 나란히 놓으면 역설이 풀린다. 콜센터 상담원 기준 AI 도입 후 시간당 처리 건수는 15% 늘었다. 같은 기간 사무직의 40%가 한 달 안에 겉만 그럴듯한 AI 산출물을 받았고, 그 한 건을 되묻고 고치는 데 평균 2시간이 들었다. 그리고 업무의 30% 이상에 AI를 쓰는 직원은 13%인데 경영진은 그 비율을 4%로 알고 있었다.
개인 단위의 생산성은 실제로 올랐다. 그러나 그 산출물을 검증하는 비용이 조직에 새로 생겼고, 경영진은 그 규모를 보지 못한다. 그래서 "빨라졌다"와 "피곤하다"가 같은 회의실에서 동시에 나온다. 문제는 AI가 아니라 AI를 둘러싼 믿음이다.
거짓말 1 — "AI를 쓰면 무조건 빨라진다"
AI 평가기관 METR이 숙련 개발자 16명에게 실제 업무 246건을 주고 AI 사용 여부를 무작위로 배정했다. 결과는 AI를 쓴 쪽이 19% 느렸다. 그런데 본인들은 "20% 빨라졌다"고 믿었다. 체감과 실측 사이에 약 40%포인트의 착시가 있었다.
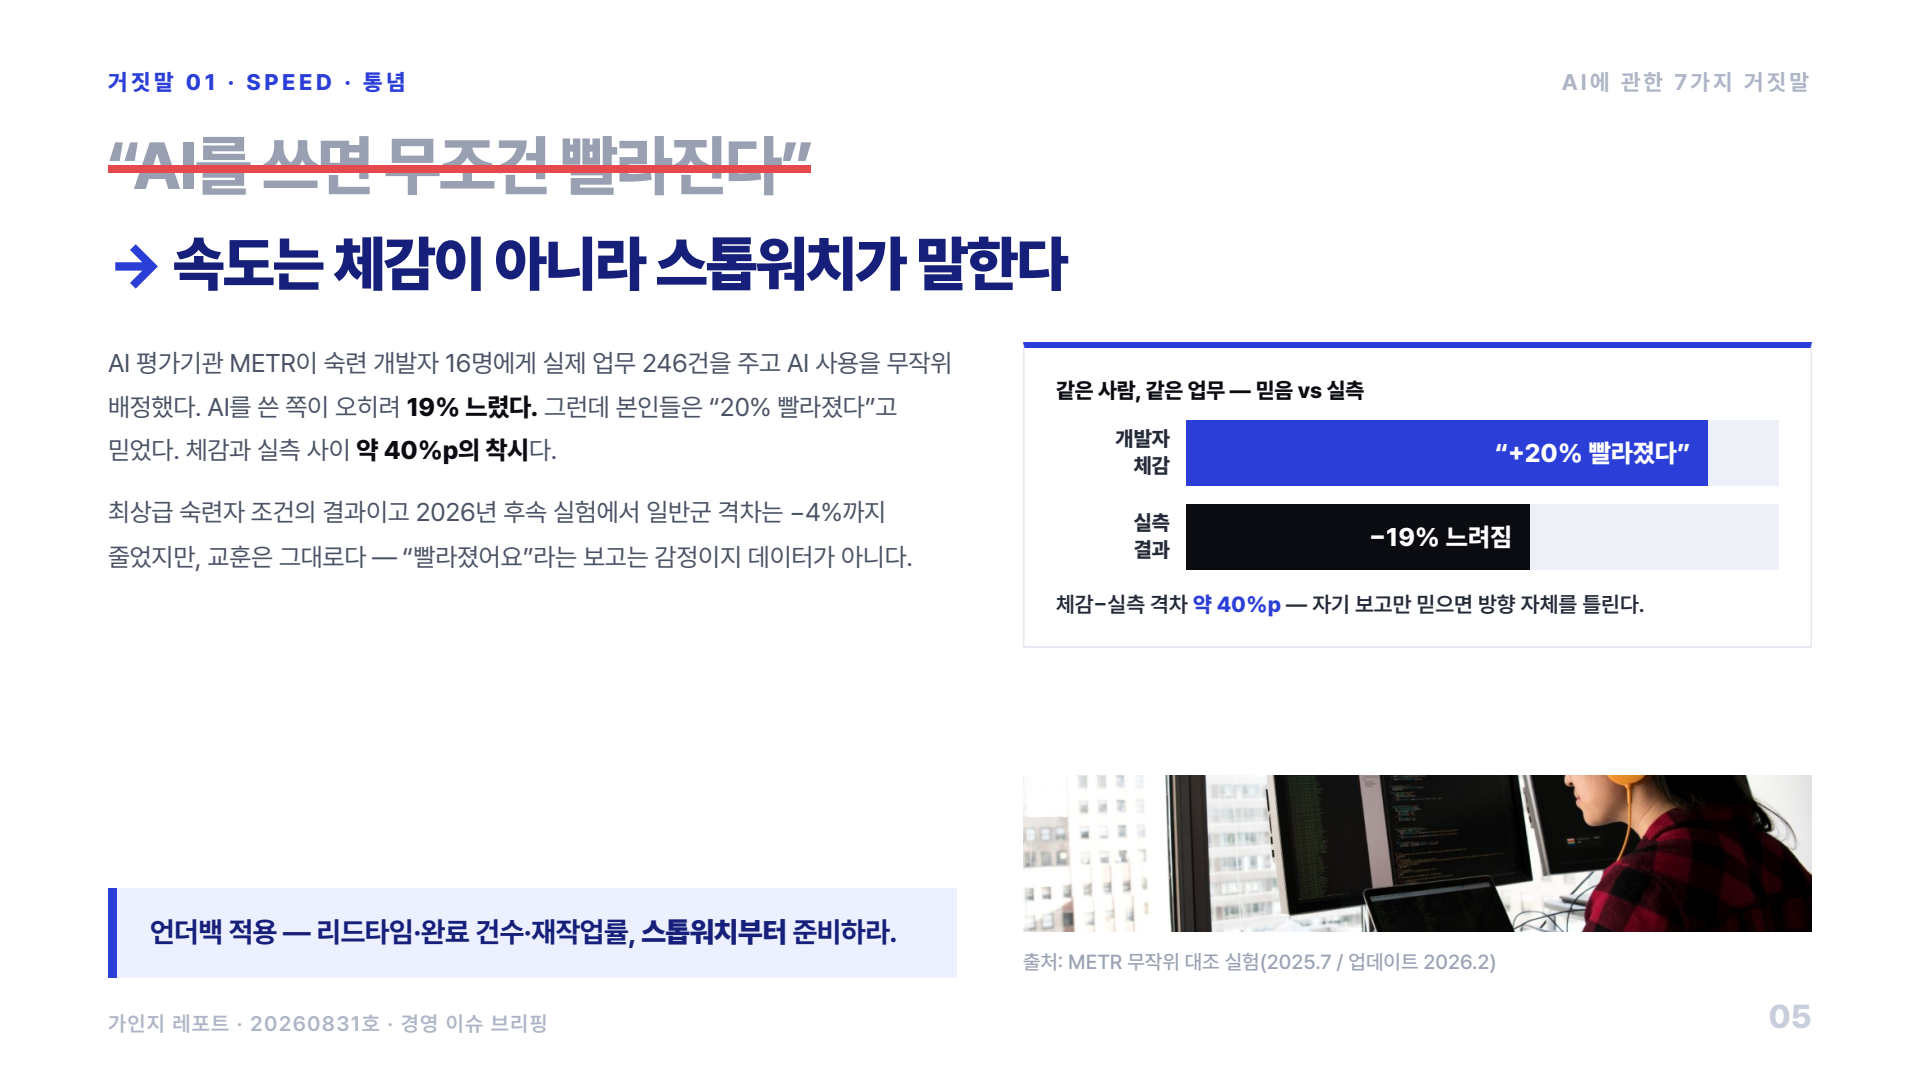
▲ METR 무작위 대조 실험. 개발자 체감은 "+20% 빨라졌다"였으나 실측은 −19%였다. (자료: METR 무작위 대조 실험 2025.7, 2026.2 업데이트 / 《가인지 레포트》 20260831호)
단서는 붙여야 한다. 최상급 숙련자 조건의 결과이고, 2026년 후속 실험에서 일반군의 격차는 −4%까지 줄었다. 그러나 교훈은 그대로다. "빨라졌어요"라는 보고는 감정이지 데이터가 아니다. 리드타임, 완료 건수, 재작업률을 재는 판부터 만들어야 한다.
거짓말 2 — "AI에 투자하면 성과가 난다"
MIT 미디어랩이 기업 AI 도입 300여 건을 검토한 「GenAI Divide」의 결론은 가혹하다. 300~400억 달러를 쏟았지만 조직의 95%는 손익계산서에 잡히는 수익이 없었다. 화려한 파일럿과 임원 시연회는 P&L을 움직이지 못했다.
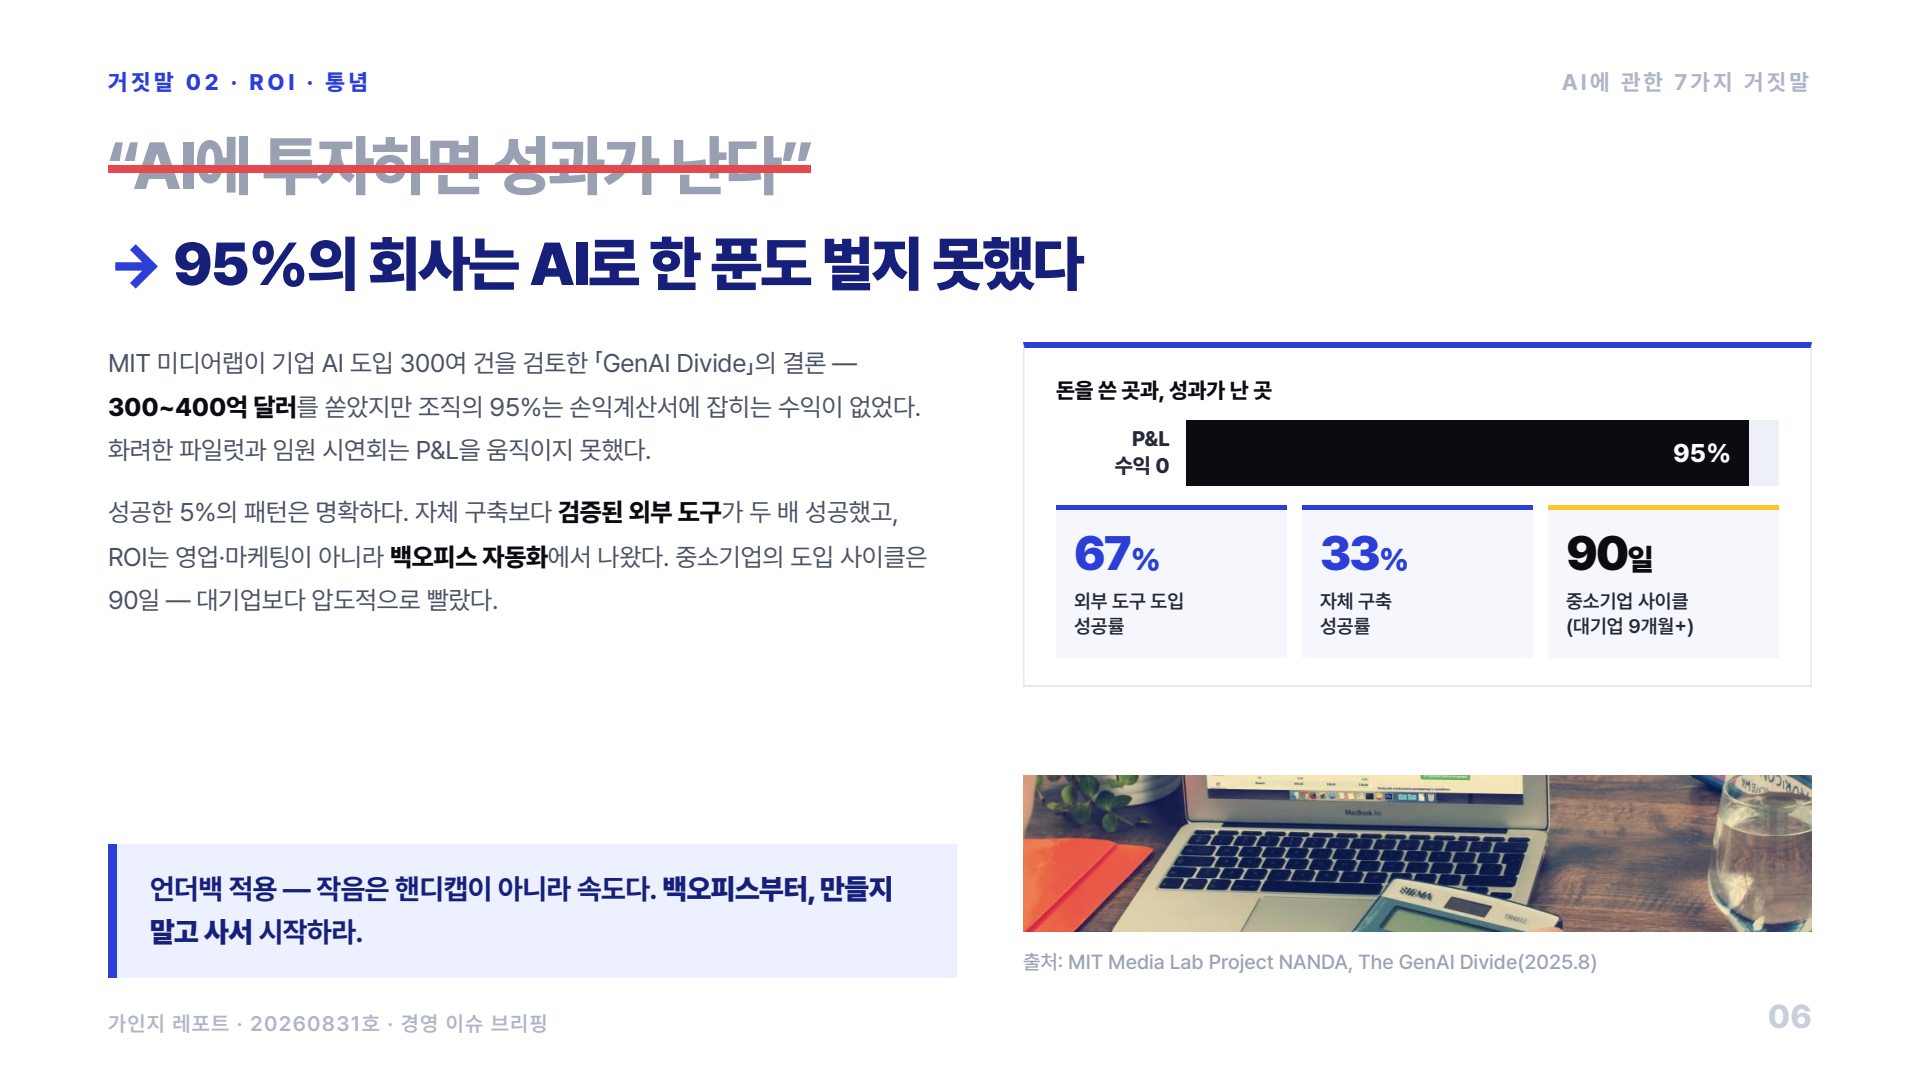
▲ 기업 AI 도입 300여 건 검토 결과 95%는 손익계산서상 수익이 없었다. 성공한 5%는 자체 구축이 아니라 외부 도구를 썼다. (자료: MIT Media Lab Project NANDA, The GenAI Divide 2025.8 / 《가인지 레포트》 20260831호)
성공한 5%의 패턴은 명확했다. 자체 구축보다 검증된 외부 도구가 두 배 성공했고(67% 대 33%), 성과는 영업·마케팅이 아니라 백오피스 자동화에서 나왔다. 그리고 중소기업의 도입 사이클은 90일로, 대기업의 9개월 이상보다 압도적으로 빨랐다. 작은 규모는 핸디캡이 아니라 속도다.
거짓말 3 — "좋은 툴과 교육만 있으면 된다"
하버드와 INSEAD 연구진이 스타트업 515곳을 무작위로 나누고 전원에게 AI 크레딧과 교육을 줬다. 단 한 그룹에만 "우리 업무의 어디에 AI를 끼울지 매핑하는 훈련"을 추가했다. 툴도 교육도 같았는데 이 그룹만 매출이 대조군 대비 약 1.9배가 됐다. AI 활용 사례 발굴은 44%, 유료 고객 확보 확률은 18% 높았다.
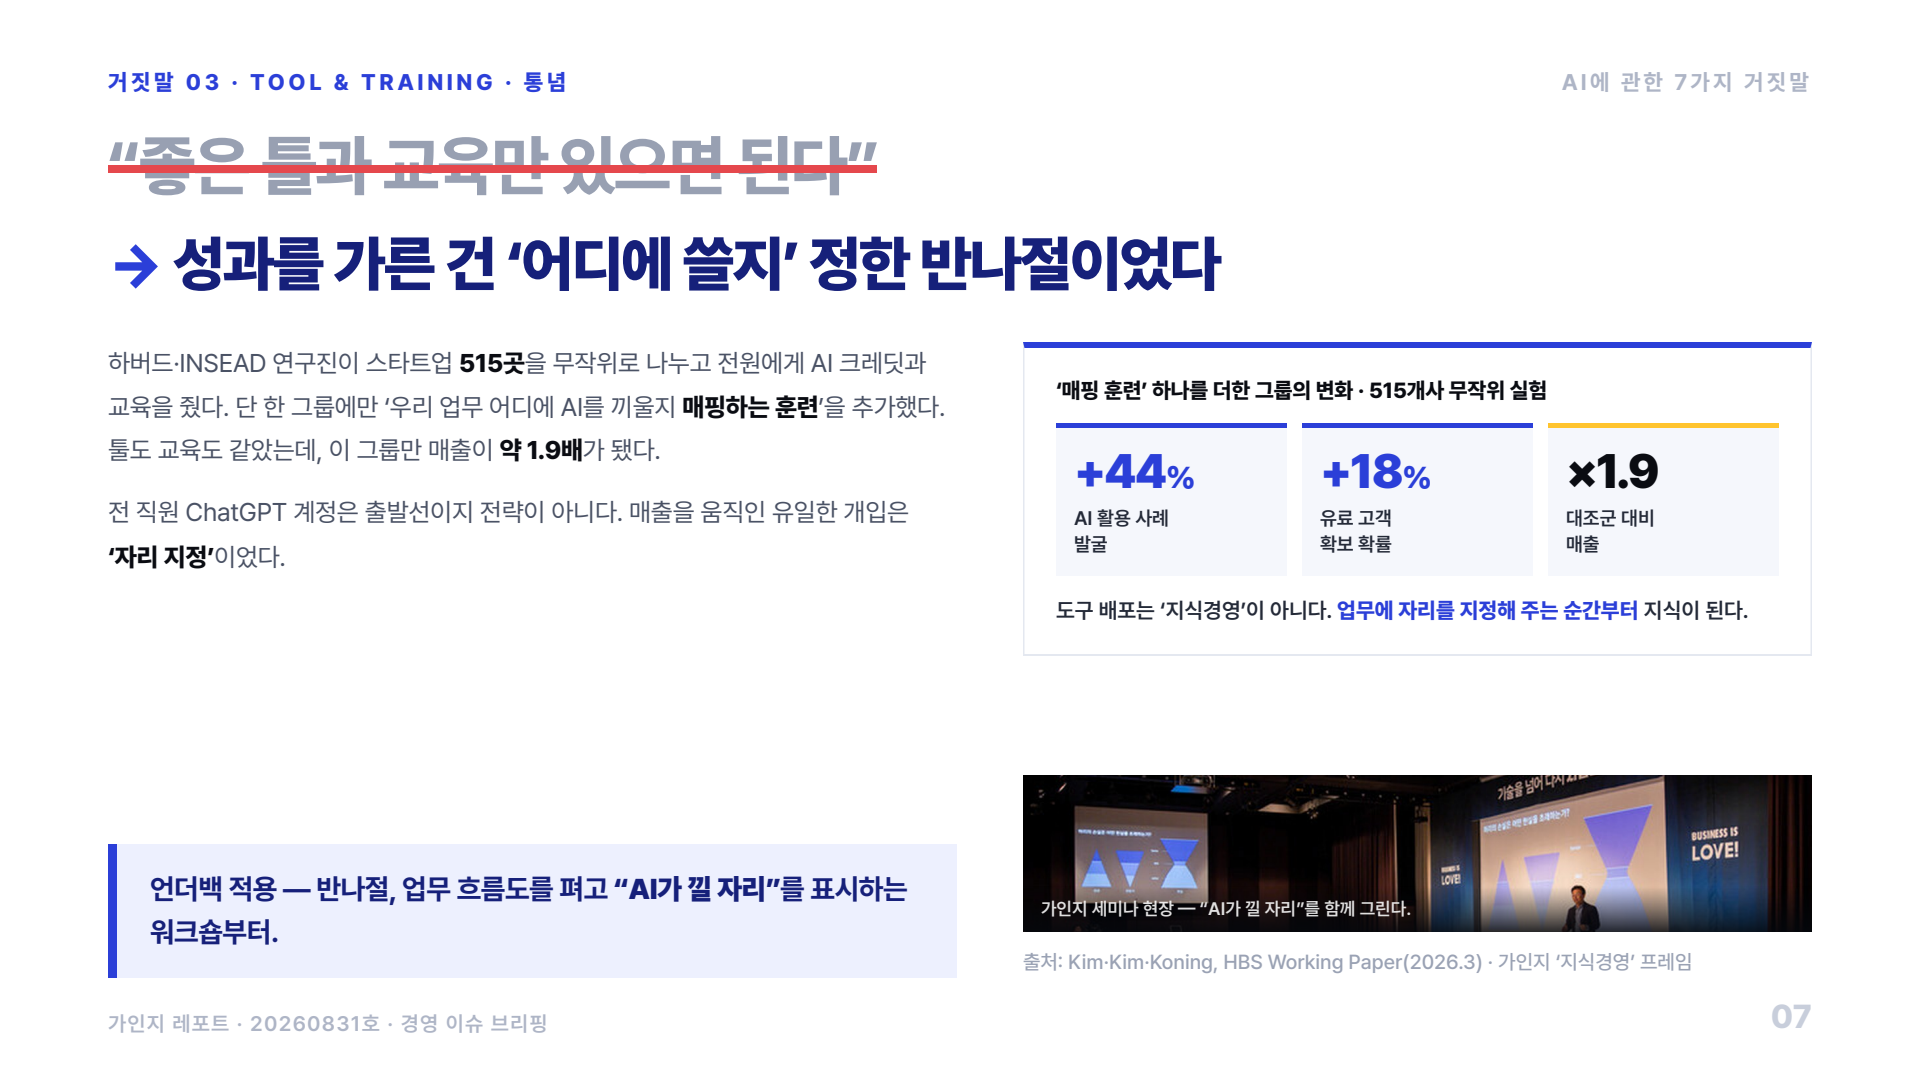
▲ 툴과 교육이 같아도 "AI가 낄 자리"를 지정한 그룹만 매출이 1.9배가 됐다. (자료: Kim·Kim·Koning, HBS Working Paper 2026.3 / 《가인지 레포트》 20260831호)
전 직원 ChatGPT 계정은 출발선이지 전략이 아니다. 매출을 움직인 유일한 개입은 자리 지정이었다. 도구 배포는 지식경영이 아니다. 업무 흐름에 자리를 지정해 주는 순간부터 지식이 된다.
거짓말 4 — "AI는 잘하는 사람을 더 잘하게 만든다"
스탠퍼드 브린욜프슨 팀이 콜센터 상담원 5,172명을 추적했다. AI 도입 후 시간당 해결 건수는 평균 15% 늘었다. 그런데 분포가 달랐다. 신입·저숙련은 30% 이상 개선된 반면 최상위 베테랑은 개선 폭이 거의 0이었다.
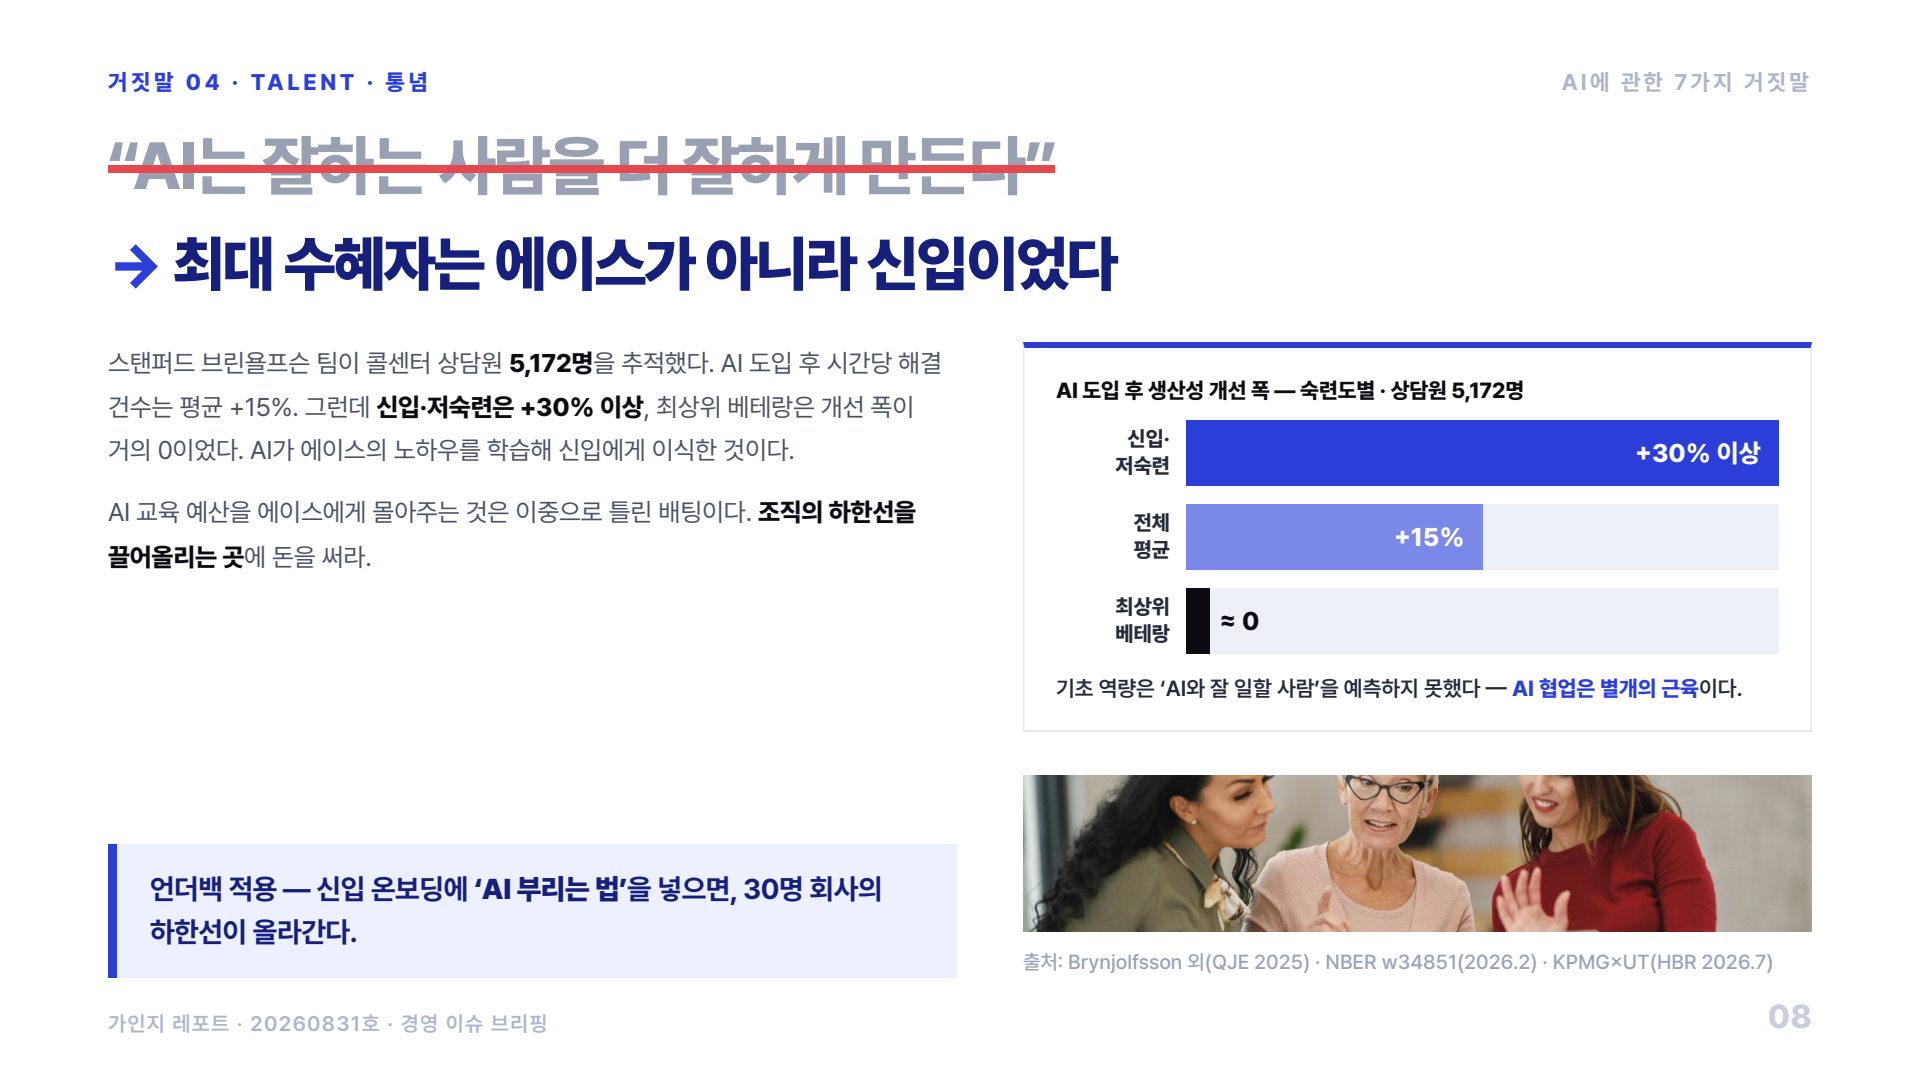
▲ AI 도입 후 생산성 개선 폭은 신입·저숙련 +30% 이상, 전체 평균 +15%, 최상위 베테랑 약 0이었다. (자료: Brynjolfsson 외 QJE 2025, NBER w34851 / 《가인지 레포트》 20260831호)
AI가 에이스의 노하우를 학습해 신입에게 이식한 것이다. 그렇다면 AI 교육 예산을 에이스에게 몰아주는 것은 이중으로 틀린 배팅이다. 돈은 조직의 하한선을 끌어올리는 곳에 써야 한다. 30명 회사라면 신입 온보딩에 "AI 부리는 법"을 넣는 것이 가장 빠르다. 덧붙여, 기초 역량은 "AI와 잘 일할 사람"을 예측하지 못했다. AI 협업은 별개의 근육이다.
거짓말 5 — "직원들이 거부해서 도입이 안 된다"
맥킨지가 6개국 직원 3,613명과 C레벨 238명을 조사했다. 경영진은 "업무의 30% 이상에 AI를 쓰는 직원"을 4%로 추정했지만 실제는 13%, 세 배였다.
와튼의 이선 몰릭은 이들을 "비밀 사이보그"라 부른다. 30~40%가 AI로 생산성을 올리지만 공개하는 비율은 20%에 그친다. 잘 쓴다고 말하면 일이 몰리거나 자리가 위험해질까 두렵기 때문이다. 병목은 직원의 저항이 아니라 경영진의 착시다. 이번 달 전체회의에서 "AI로 시간 아낀 사례"를 발표하게 하는 것만으로도 신호가 바뀐다. 벌이 아니라 상이 온다는 신호여야 한다.
거짓말 6 — "AI를 쓰면 팀이 더 창의적이 된다"
MIT 슬론이 창의성 실험 4건을 종합했다. AI는 개인 결과물의 품질을 일관되게 올렸다. 그러나 팀 전체로 보면 아이디어의 다양성이 줄었다. 같은 모델에 기댄 사람들의 산출물은 서로 닮아간다.
아이디어 회의에서 처음부터 AI를 열게 하면, 회의실에는 사실상 한 명의 참석자만 남는다. 개인 품질 상승과 집단 다양성 하락이 동시에 일어난다. 해법은 금지가 아니라 순서다. 회의 규칙 한 줄이면 된다. "AI 없이 각자 초안을 쓰고, 그다음 AI로 다듬는다."
거짓말 7 — "AI 산출물이 많아지면 생산성이 오른다"
스탠퍼드와 BetterUp이 사무직 1,150명을 조사해 만든 신조어가 워크슬롭(workslop)이다. 겉은 번지르르하지만 알맹이 없는 AI 산출물을 가리킨다. 사무직의 40%가 한 달 안에 이를 받았고, 한 건을 되묻고 고치는 데 평균 2시간을 썼다. 1인당 월 186달러의 보이지 않는 세금이다.
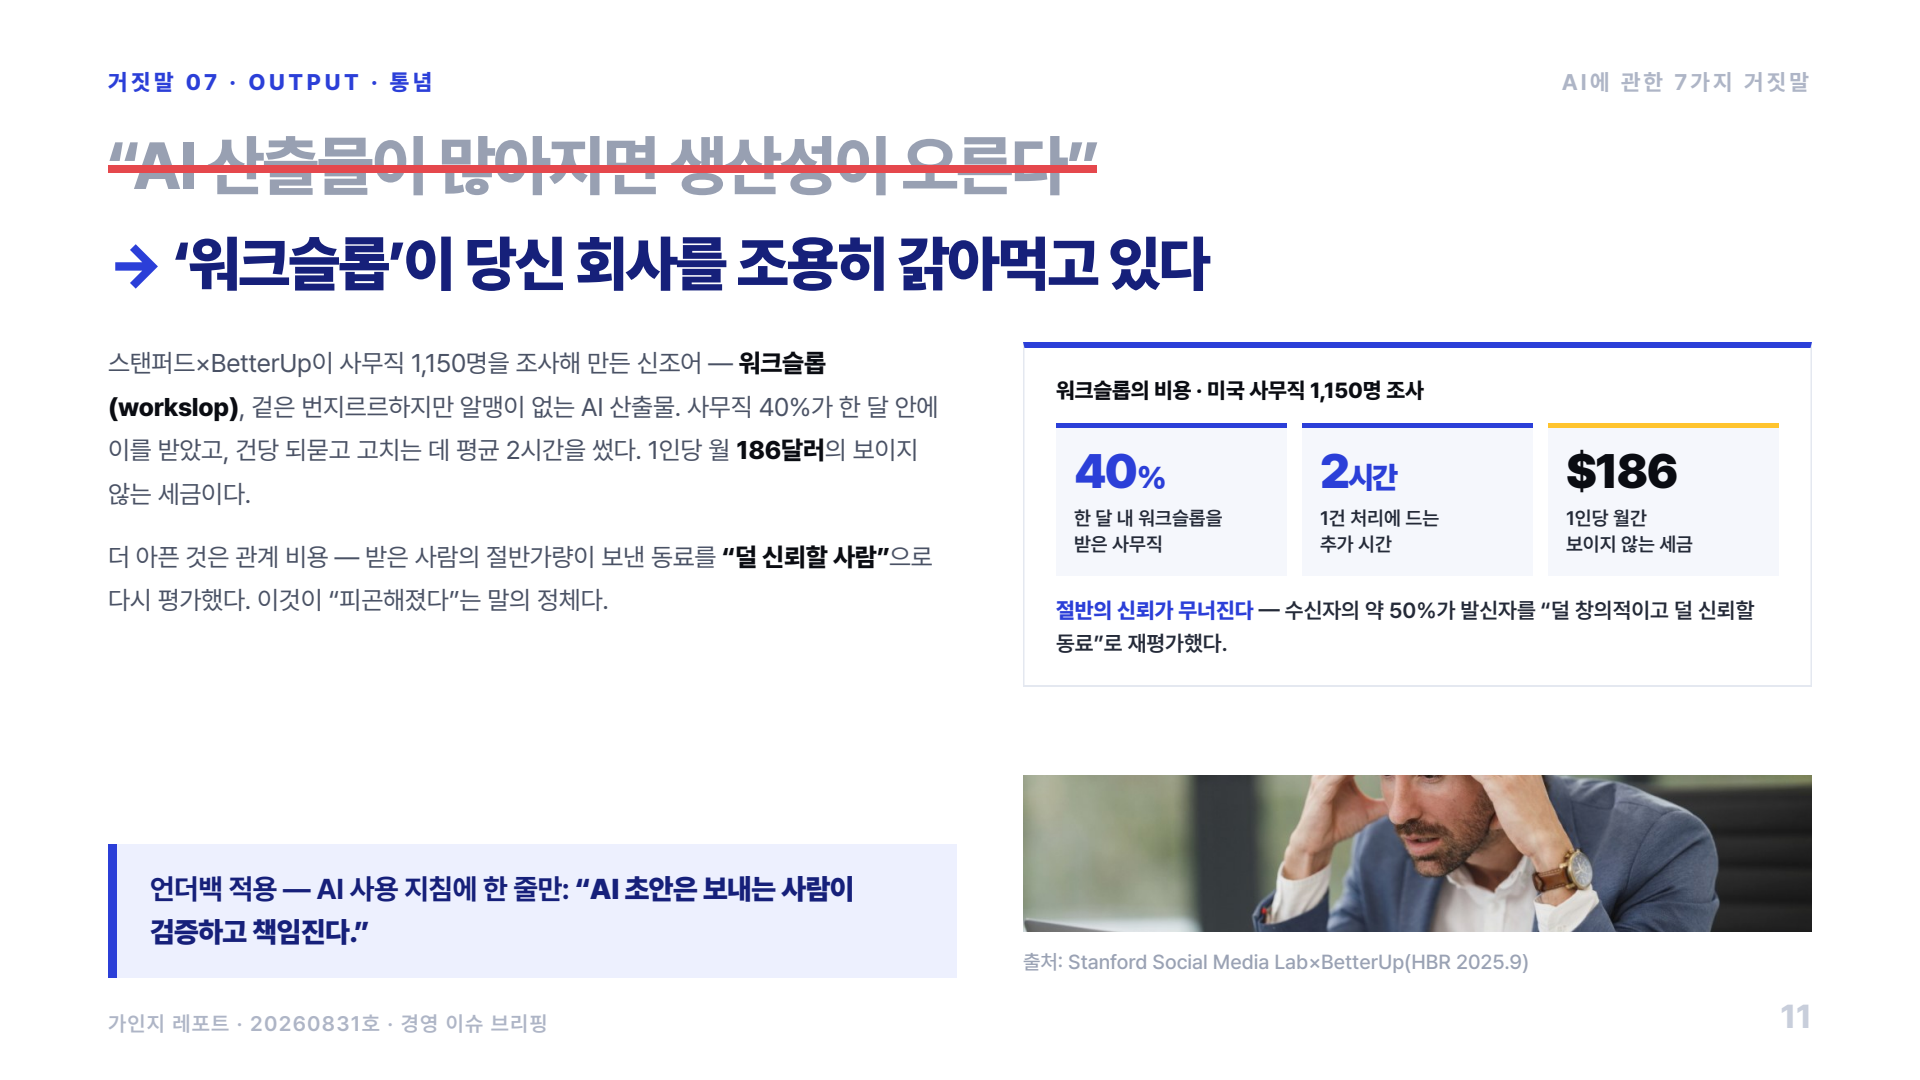
▲ 사무직 40%가 한 달 내 워크슬롭을 받았고, 1건 처리에 평균 2시간이 들었다. 수신자의 약 50%는 발신자를 덜 신뢰할 동료로 재평가했다. (자료: Stanford Social Media Lab×BetterUp, HBR 2025.9 / 《가인지 레포트》 20260831호)
더 아픈 것은 관계 비용이다. 받은 사람의 약 절반이 보낸 동료를 "덜 창의적이고 덜 신뢰할 사람"으로 다시 평가했다. "AI 때문에 피곤하다"는 말의 정체가 여기 있다. AI 사용 지침에 한 줄만 넣으면 된다. "AI 초안은 보내는 사람이 검증하고 책임진다."
이 결과를 읽을 때 주의할 것
숫자를 과장하지 않기 위해 한계를 적는다. METR 실험은 최상급 숙련 개발자 16명을 대상으로 했고, 후속 실험에서 일반군의 격차는 −19%에서 −4%까지 좁혀졌다. MIT의 95%는 손익계산서에 잡히는 수익을 기준으로 한 것이어서, 업무 시간 절감처럼 장부에 안 잡히는 효과는 제외돼 있다. 맥킨지와 스탠퍼드 조사는 자기 보고에 기반한다.
그럼에도 일곱 개 연구가 공통으로 가리키는 방향은 흔들리지 않는다. 국가도 표본도 방법도 다른 연구들이 같은 지점을 짚었다. 측정하지 않은 속도, 자리를 정하지 않은 도구, 검증하지 않은 산출물. 세 가지가 반복해서 나온다.
일곱 개가 가리킨 하나의 진실
일곱 개의 연구가 가리킨 곳은 결국 하나였다. AI의 성패는 기술이 아니라 설계에서 갈린다.
피곤함의 정체는 검증 비용이고, 병목은 경영진의 착시이며, 언더백의 무기는 90일의 속도다. 그러므로 물어야 할 것은 "어떤 모델을 쓸까"가 아니다. "우리 일의 어디에 자리를 내줄까"다.
이번 주에 할 수 있는 네 가지
① 측정판을 만든다. 리드타임, 완료 건수, 재작업률. 세 칸이면 체감과 실측의 격차가 드러난다.
② 백오피스 업무 하나를 골라 90일만 사서 돌린다. 만들지 말고 산다. 자체 구축의 성공률은 외부 도구의 절반이었다.
③ 반나절 워크숍으로 자리를 지정한다. 업무 흐름도를 펴고 AI가 낄 자리를 표시한다. 매출을 움직인 유일한 개입이다.
④ 지침 두 줄을 명문화한다. "초안은 AI 없이 각자." "AI 산출물은 보내는 사람이 검증한다." 다양성 하락과 워크슬롭을 동시에 막는다.
가인지컨설팅그룹 김경민 대표는 "현장에서 AI 도입을 상담하면 대개 어떤 도구를 쓸지부터 묻는데, 25년간 약 4,000개 기업을 만나며 확인한 것은 도구가 성패를 가른 적이 거의 없다는 사실"이라며 "이번 일곱 개 연구가 공통으로 가리킨 것도 같다. 측정하지 않았고, 자리를 정하지 않았다는 것"이라고 말했다.
김 대표는 이어 "언더백 기업이 대기업보다 유리한 지점이 바로 여기"라며 "도입 사이클이 90일이면 분기 안에 결과를 보고 방향을 틀 수 있다. 9개월 걸리는 조직은 틀렸다는 사실조차 다음 해에 안다"고 덧붙였다.
글 | 이평화 기자
※ 본 글은 《가인지 레포트》 2026년 8월 31일자 「AI에 관한 7가지 거짓말」(24면)을 재구성한 것이다. 인용된 연구는 METR(2025.7, 2026.2), MIT Media Lab Project NANDA(2025.8), Kim·Kim·Koning HBS Working Paper(2026.3), Brynjolfsson 외 QJE(2025) 및 NBER w34851(2026.2), McKinsey Superagency(2025.1), MIT Sloan Management Review(2026.7), Stanford Social Media Lab×BetterUp(HBR 2025.9)이다.